

OpenAI y Microsoft sabían que estaban iniciando un «bucle del destino» para Internet
Recientemente premiado documentos judiciales en Nueva YorkEl caso contra OpenAI y Microsoft lo suficiente como para estar condenado. Los propios documentos del grupo advertían que comenzaría con un «bucle fetal» que dañaría la web, raspando sus datos para establecer sus modelos como «el mayor robo de mano de obra en la historia de la humanidad» y «haciendo una completa burla de la idea de uso legítimo».
Muchas de las mejores citas provienen del Director de Ciencias Aplicadas de Microsoft, Brent Hecht. Sin embargo, la empresa ha intentado distanciarse de las afirmaciones de Hecht. El portavoz de Microsoft, Alex Haurek, dijo a The Verge que «estos comentarios reflejan la perspectiva de un empleado individual, no son análisis legales y no representan los puntos de vista de la empresa».
En un expediente judicial separado, Jordan Usdan, director general de estrategia y operaciones de datos de Microsoft AI, fue nombrado adversario de Hecht. Hecht dijo que «tener opiniones diversas, académicas y preparadas sobre cómo se debe manejar y utilizar el ecosistema de datos para la IA en Microsoft conduce a opiniones asimétricas, futuristas y académicas… y él no es quien habla específicamente en nombre de Microsoft con respecto a opiniones especulativas sobre los efectos potenciales de la IA en los creadores de contenido».
Pero está claro si Microsoft quiere tener estos comentarios. esta es la verdad. ¡Google no es real! ¡La IA se está comiendo la web!
Hay muchas más ideas descabelladas. NYT presentación de varias figuras, incluidos Satya Nadella, Sam Altman y otros empleados de OpenAI. A continuación se muestran algunos aspectos destacados de la página 92 del documento.
«Robo impresionante»

La introducción presenta a Hecht y al director de OpenAI de ChatGPT (es decir, Nick Turley), aparentemente mostrando que las empresas sabían que representaban una amenaza «existencial» similar para los editores. Nueva York. Hecht califica la recolección de datos de ChatGPT y Copilot como «el mayor robo de mano de obra en la historia de la humanidad» y dice que la defensa de Microsoft constituye «una completa burla de la idea de ‘uso justo'».
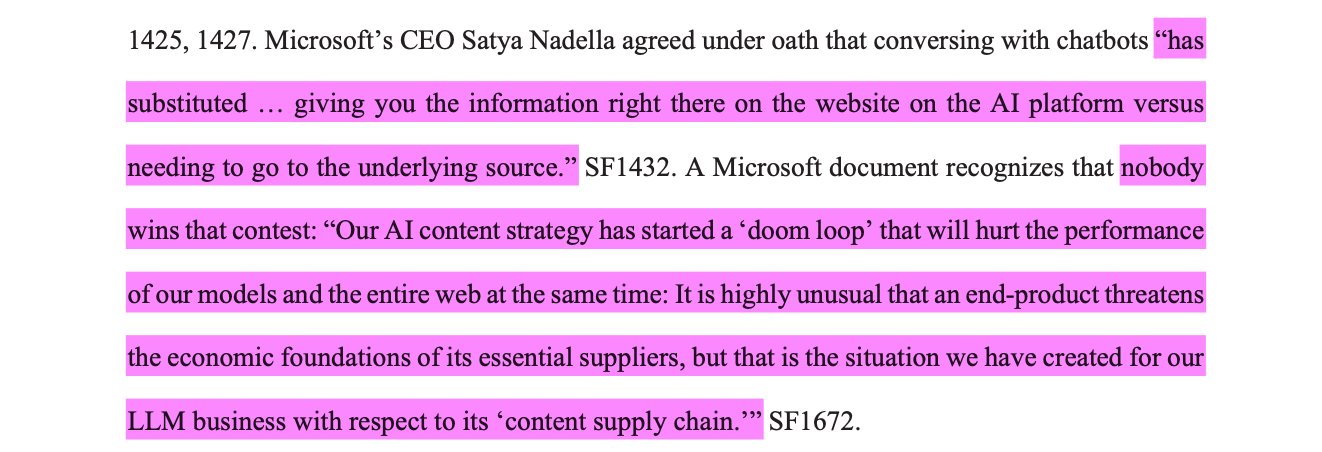
Satya Nadella admite que los chatbots han reemplazado fundamentalmente la búsqueda y han eliminado la necesidad de ir directamente a la fuente de información. Pero quizás lo más condenatorio sea un documento interno de Microsoft que dice: «Nuestro proyecto de contenido de IA ha iniciado un «bucle fetal» que dañará nuestros modelos y toda la web al mismo tiempo: es muy inusual que el producto final amenace las bases financieras de los proveedores esenciales, pero hemos creado un negocio para nuestro negocio LLM con respecto a su «cadena de suministro de contenido».
ese no es un numero real

No se deje engañar por OpenAI o las afirmaciones altruistas de Microsoft. El cofundador de OpenAI, Greg Brockman, está más interesado en los «millones» de dólares que podrían ganarse a través de la IA comercial.

Aunque más tarde se citó a Nadella diciendo que «hay que pagar algo para obtener la licencia», un representante de OpenAI admitió que «no tenía conocimiento» de ningún intento de detectar o eliminar contenido pago de los datos de la organización.
«Increíblemente buena regurgitación»

Internamente, parece que OpenAI es muy consciente de la intención de ChatGPT de simplemente reproducir «textualmente» material protegido por derechos de autor. Aunque reconoció que «prevenir la memorización» es importante para minimizar las violaciones de derechos de autor, los trabajadores reconocieron que GPT-4 «recuerda una tonelada de información y, por lo tanto, sería increíblemente bueno regurgitando».
Luego, el archivo proporciona más ejemplos de cómo ChatGPT genera un patrón de cadena larga directamente de los artículos sobre Veces, Mercurio Noticias, Correo de Denver, hackery eurogamer en respuesta a sus preguntas.
«‘Aspirando’ todo su trabajo»

Microsoft sabía cómo se percibiría todo su raspado de Internet y admitió que «casi nadie tenía la intención (sic) de crear contenido para ser utilizado de esa manera, y no reciben compensación por el uso».
Un «por el trabajo de los hombres»